
模型 API 如何稳定接入?从消息结构到结构化输出
内容摘要:Agent 的一切都建立在「一次模型调用」之上。本章讲清消息角色、关键参数、结构化输出与流式输出,并给出一个厂商中立、带类型标注与异常处理的最小客户端封装,供后续所有章节复用。 难度:入门 | 适用版本:OpenAI 兼容 Chat Completions 接口,
verified_at: 2026-09-07| 前置知识:01 基础
常见误区
接口返回 HTTP 200 和一段看似合理的文字,就代表 Agent 可以安全地进入下一步。
先给结论
先找左上方的服务与信封、右上方的消息窗口,再看下方的计时表和增量块:它们分别提醒我们检查服务交互、上下文、延迟和流式传输。
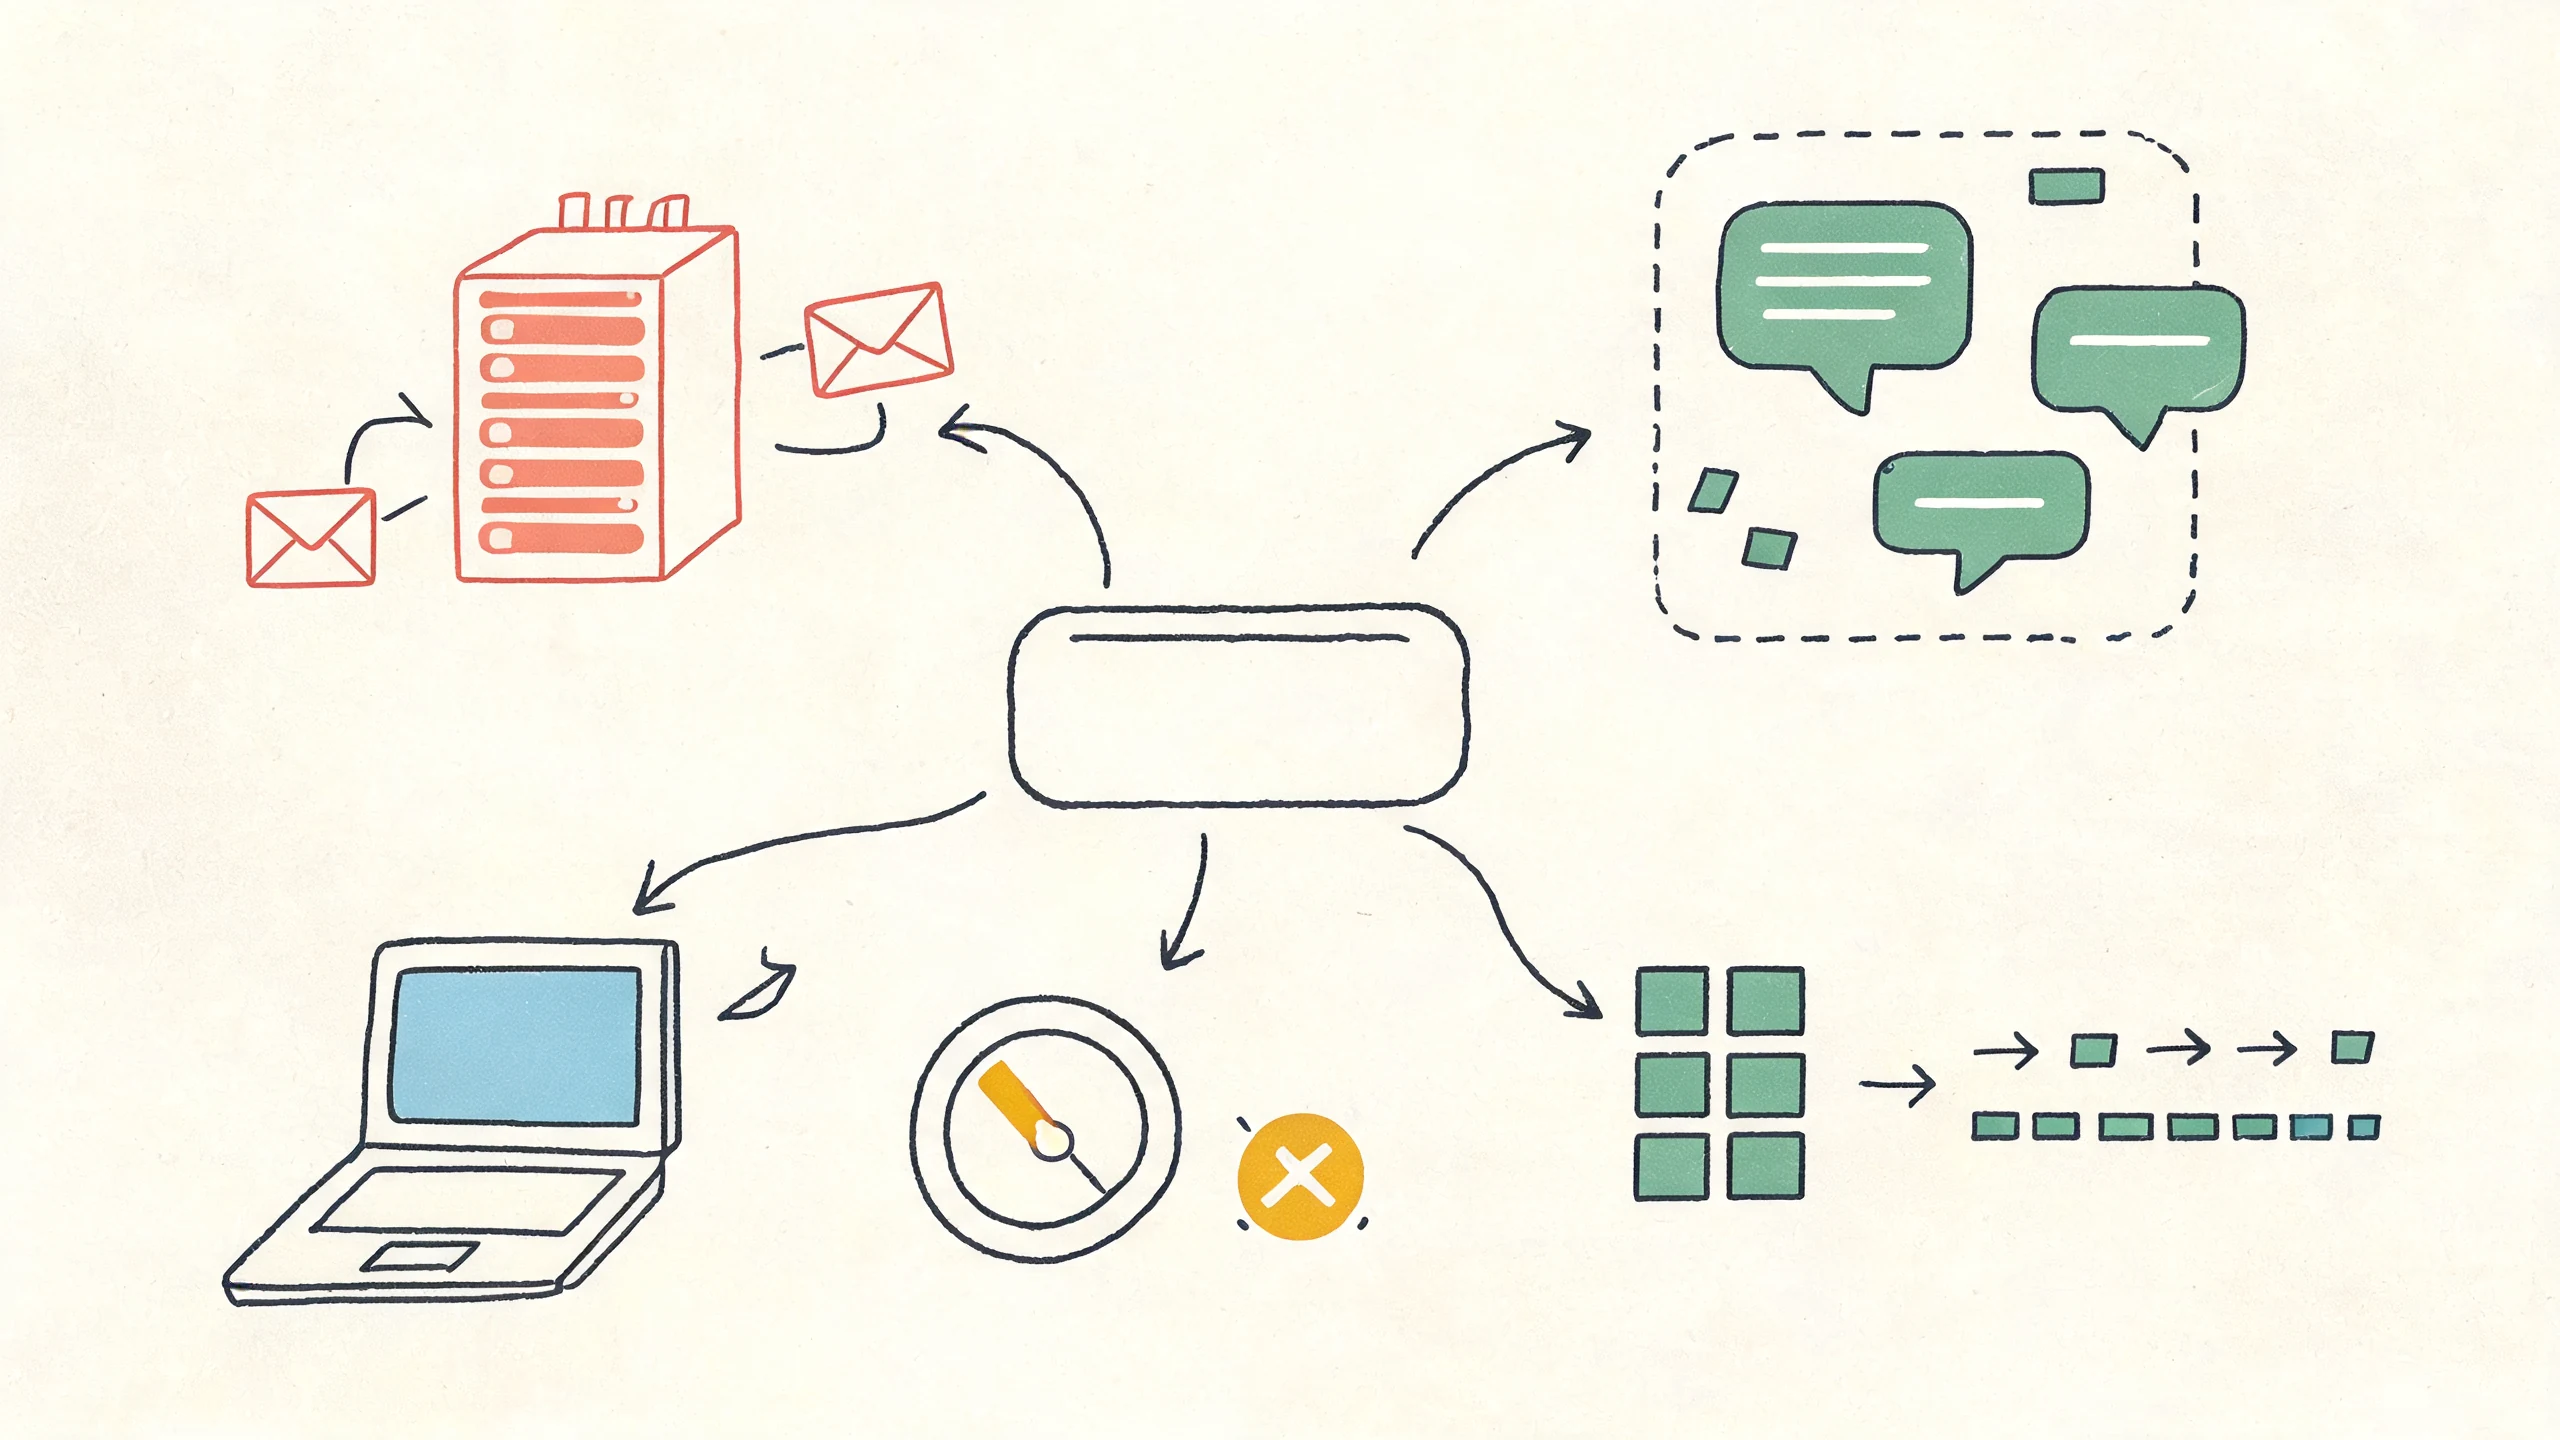
图 1:模型接入要同时管理消息、输出契约、传输状态和错误。
这些是同一次调用的不同维度。服务成功返回,不代表消息角色使用正确,也不代表返回值已完整、可解析或符合业务规则。插画用于列出检查对象,调用顺序以代码为准。
Agent 需要的是可验证的机器契约,而不是“看起来像 JSON”的文本。应分离传输错误、供应商错误、Schema 错误和业务规则错误,并对结构化输出做严格解析、超时控制与失败降级。
带着这三个问题阅读:
- system、user、assistant 与 tool 消息分别由谁产生、承担什么职责?
- 结构化输出为什么仍需 JSON Schema 和业务规则双重校验?
- 流式输出改善了什么,又会引入哪些中断与拼接问题?
一、消息结构:Agent 的输入长什么样
主流对话式模型接受一个消息数组,每条消息有 role 和 content:
| 角色 role | 用途 | 谁产生 |
|---|---|---|
system | 系统指令:设定身份、行为要求与输出格式;不构成执行权限边界 | 开发者 |
user | 用户输入 / 当前目标 | 用户 |
assistant | 模型的历史回复(多轮时回填) | 模型 |
tool | 工具执行结果(工具调用后回填) | 应用 |
[
  { "role": "system", "content": "你是知识库运维助手,只基于提供的上下文回答,不臆测。" },
  { "role": "user", "content": "mysql-test-01 有没有慢查询?" }
]安全提示:
system指令的优先级高,但不能仅靠它防注入。user与tool里的内容都可能试图覆盖系统指令,见 14 安全。
二、关键参数速查
| 参数 | 作用 | Agent 建议 |
|---|---|---|
model | 模型名 | 用环境变量注入,便于降级/切换(18) |
messages | 消息数组 | 由上下文工程构造(05) |
temperature | 随机性 | 决策/工具调用用接近 0 |
max_tokens | 输出上限 | 必设,防失控 |
tools / tool_choice | 声明可用工具 | 见 06 工具调用 |
response_format | 结构化输出约束 | 需要机读结果时用 |
stream | 是否流式 | 面向用户交互时用 |
三、最小可运行客户端(厂商中立封装)
后续章节复用这个封装。它依赖目标服务兼容所用的 Chat Completions 参数。真实调用时通过环境变量注入凭据;文档不提供真实密钥,示例中的虚构值只能说明配置方式。
"""通用 LLM 客户端封装:厂商中立、带类型与异常处理。
依赖:pip install "openai>=1.0"
环境变量:MODEL_API_KEY / MODEL_BASE_URL / MODEL_NAME
"""
from __future__ import annotations
import os
from dataclasses import dataclass
from openai import OpenAI, APIError, APITimeoutError, RateLimitError


@dataclass
class LLMConfig:
    api_key: str
    base_url: str
    model: str
    timeout_s: float = 30.0

    @classmethod
    def from_env(cls) -> "LLMConfig":
        try:
            return cls(
                api_key=os.environ["MODEL_API_KEY"],
                base_url=os.environ["MODEL_BASE_URL"],
                model=os.environ["MODEL_NAME"],
            )
        except KeyError as e:
            raise RuntimeError(f"缺少环境变量:{e}. 请设置 MODEL_API_KEY/MODEL_BASE_URL/MODEL_NAME") from e


class LLMError(Exception):
    """统一的模型调用异常,便于上层区分处理。"""


def chat(cfg: LLMConfig, messages: list[dict], *, temperature: float = 0.0,
         max_tokens: int = 512) -> str:
    """一次非流式对话调用,返回文本。区分超时/限流/其他 API 错误。"""
    client = OpenAI(api_key=cfg.api_key, base_url=cfg.base_url, timeout=cfg.timeout_s)
    try:
        resp = client.chat.completions.create(
            model=cfg.model, messages=messages,
            temperature=temperature, max_tokens=max_tokens,
        )
    except APITimeoutError as e:
        raise LLMError(f"模型调用超时({cfg.timeout_s}s)") from e
    except RateLimitError as e:
        raise LLMError("触发限流,应退避重试") from e
    except APIError as e:
        raise LLMError(f"模型 API 错误:{e}") from e
    if not resp.choices:
        raise LLMError("模型返回空 choices")
    return resp.choices[0].message.content or ""


if __name__ == "__main__":
    cfg = LLMConfig.from_env()
    print(chat(cfg, [
        {"role": "system", "content": "你只回答一句话。"},
        {"role": "user", "content": "用一句话解释什么是回表。"},
]))输入与预期输出:设置好环境变量后运行,预期打印一句话的中文解释。若环境变量缺失,预期抛出清晰的 RuntimeError(这是失败路径之一)。
[待验证]:需要真实(或兼容)模型服务才能执行。无服务时,可用 06 中的 Mock 模型进行离线测试。
四、结构化输出:让结果可被程序消费
沿信封、处理机器、筛选闸门到结果托盘观察:原始文本必须先转换成数据,再接受结构与业务检查。回路只表示可以修正输入后再试,并不表示所有错误都应该自动重试。
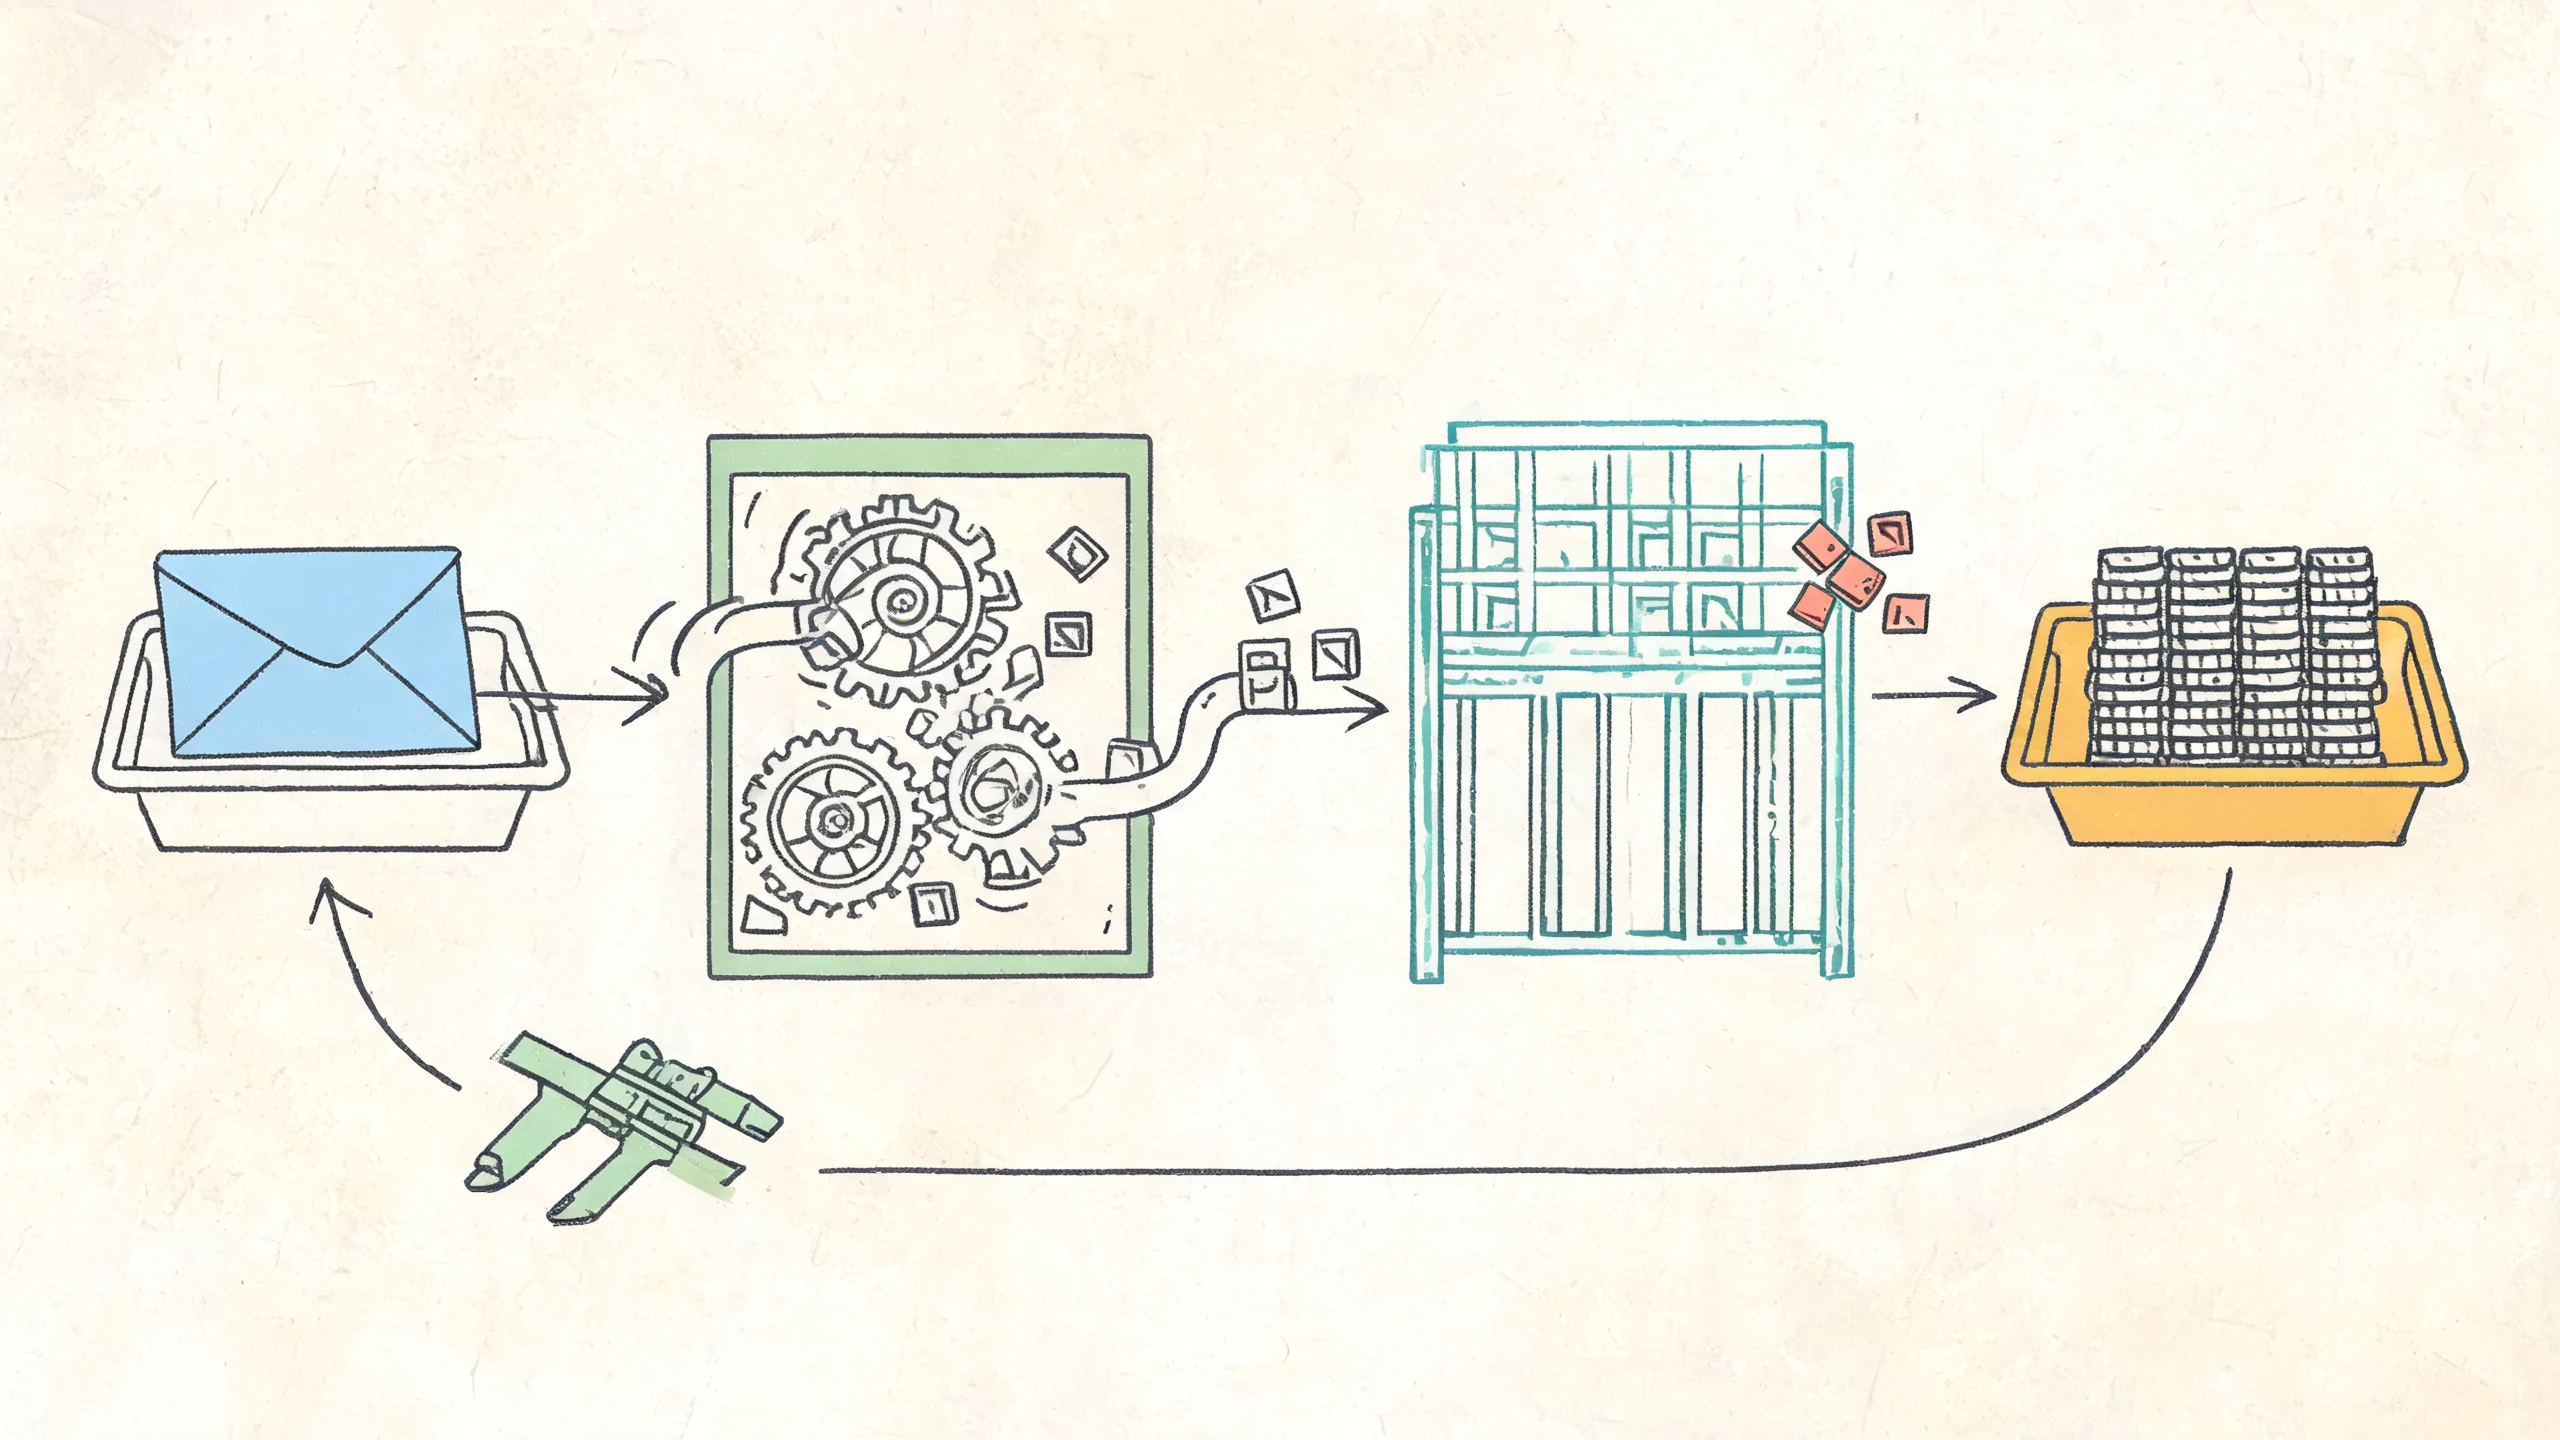
图 2:解析、结构校验和业务校验必须逐层完成。
例如,risk="high" 和 need_human_approval=false 分别都可能通过字段类型检查,但二者的组合违反本例“高风险必须审批”的规则。结构正确只是第一道门,字段之间的业务关系还要由应用验证。
Agent 经常需要机读的结果(如「是否需要人工审批」「提取出的实体」)。常见的三种方式如下;工具调用与结构化响应是不同接口形态,不能一概按名称判断约束强弱:
- 提示约束(最弱):在 system 里要求「只输出 JSON」。简单但模型可能带上多余文字。
response_formatJSON 模式 / JSON Schema:JSON 模式通常只约束语法;严格 Schema 模式还能约束受支持的结构。具体能力依供应商与模型而定,拒绝、截断和接口错误仍需处理。- 工具调用:把「输出结构」建模成工具参数 Schema(见 06);是否严格遵循 Schema 同样取决于接口能力。
无论哪种,都必须在拿到结果后再校验一次,不能信任模型「声称」的格式:
import json
from jsonschema import validate, ValidationError  # pip install jsonschema

TRIAGE_SCHEMA = {
    "type": "object",
    "properties": {
        "need_human_approval": {"type": "boolean"},
        "risk": {"type": "string", "enum": ["low", "high"]},
        "reason": {"type": "string", "minLength": 1, "maxLength": 500},
    },
    "required": ["need_human_approval", "risk", "reason"],
    "additionalProperties": False,
}

def parse_triage(raw: str) -> dict:
    """解析并校验模型的结构化输出,失败即抛错,绝不'带病放行'。"""
    try:
        data = json.loads(raw)
    except json.JSONDecodeError as e:
        raise ValueError(f"模型输出不是合法 JSON:{e}") from e
    try:
        validate(instance=data, schema=TRIAGE_SCHEMA)
    except ValidationError as e:
        raise ValueError(f"结构化输出不符合 Schema:{e.message}") from e
    if data["risk"] == "high" and not data["need_human_approval"]:
        raise ValueError("业务规则冲突:高风险操作必须要求人工审批")
    return data

# 成功路径
print(parse_triage('{"need_human_approval": true, "risk": "high", "reason": "涉及 kill 查询"}'))
# 失败路径(缺字段):抛出 ValueError
# parse_triage('{"risk": "high"}')
本例的校验只能排除字段缺失、类型错误和这条业务冲突,不能证明模型给出的风险等级真实可信。实际工具执行前还应根据目标资源和动作重新计算风险并鉴权;不能让模型把危险动作标成 low 后绕过审批。
五、流式输出:改善首字延迟
自回归生成使总延迟随输出长度增长。流式输出(streaming) 让模型逐 Token 返回,用户能更快看到首字:
def chat_stream(cfg: LLMConfig, messages: list[dict], *, max_tokens: int = 512):
    """流式返回文本增量。生产中还应处理中断、超时与取消。"""
    client = OpenAI(api_key=cfg.api_key, base_url=cfg.base_url, timeout=cfg.timeout_s)
    stream = client.chat.completions.create(
        model=cfg.model, messages=messages, max_tokens=max_tokens, stream=True,
    )
    for chunk in stream:
        delta = chunk.choices[0].delta.content if chunk.choices else None
        if delta:
            yield delta
TypeScript(严格模式)等价的类型约定:
type ChatMessage = {
  role: "system" | "user" | "assistant" | "tool";
  content: string;
};

type ChatResult =
  | { ok: true; text: string }
| { ok: false; error: string };流式只改善体验,不减少总 Token 与总成本;且流式下更难做「输出完成后统一校验」,对结构化输出要谨慎。
六、失败路径
- 空返回 / 截断:
max_tokens太小或命中停止序列,得到半截 JSON——务必校验。 - 超时与限流:区别处理,限流应退避重试(15),不要无限重试。
- 格式漂移:模型偶尔在 JSON 外加解释文字,用严格解析 + 校验兜底。
七、测试与验证
- 对
parse_triage写单测,覆盖:合法、非法 JSON、缺必填、枚举越界、超长。 - 对客户端封装用假服务器 / Mock 覆盖超时、限流、5xx,验证异常映射正确。
八、安全与权限
对比两侧的门禁:左侧输入直接进入处理节点,右侧增加独立授权和隔离边界。关键差别是应用会检查动作能否执行,而不是只在提示词里要求谨慎。
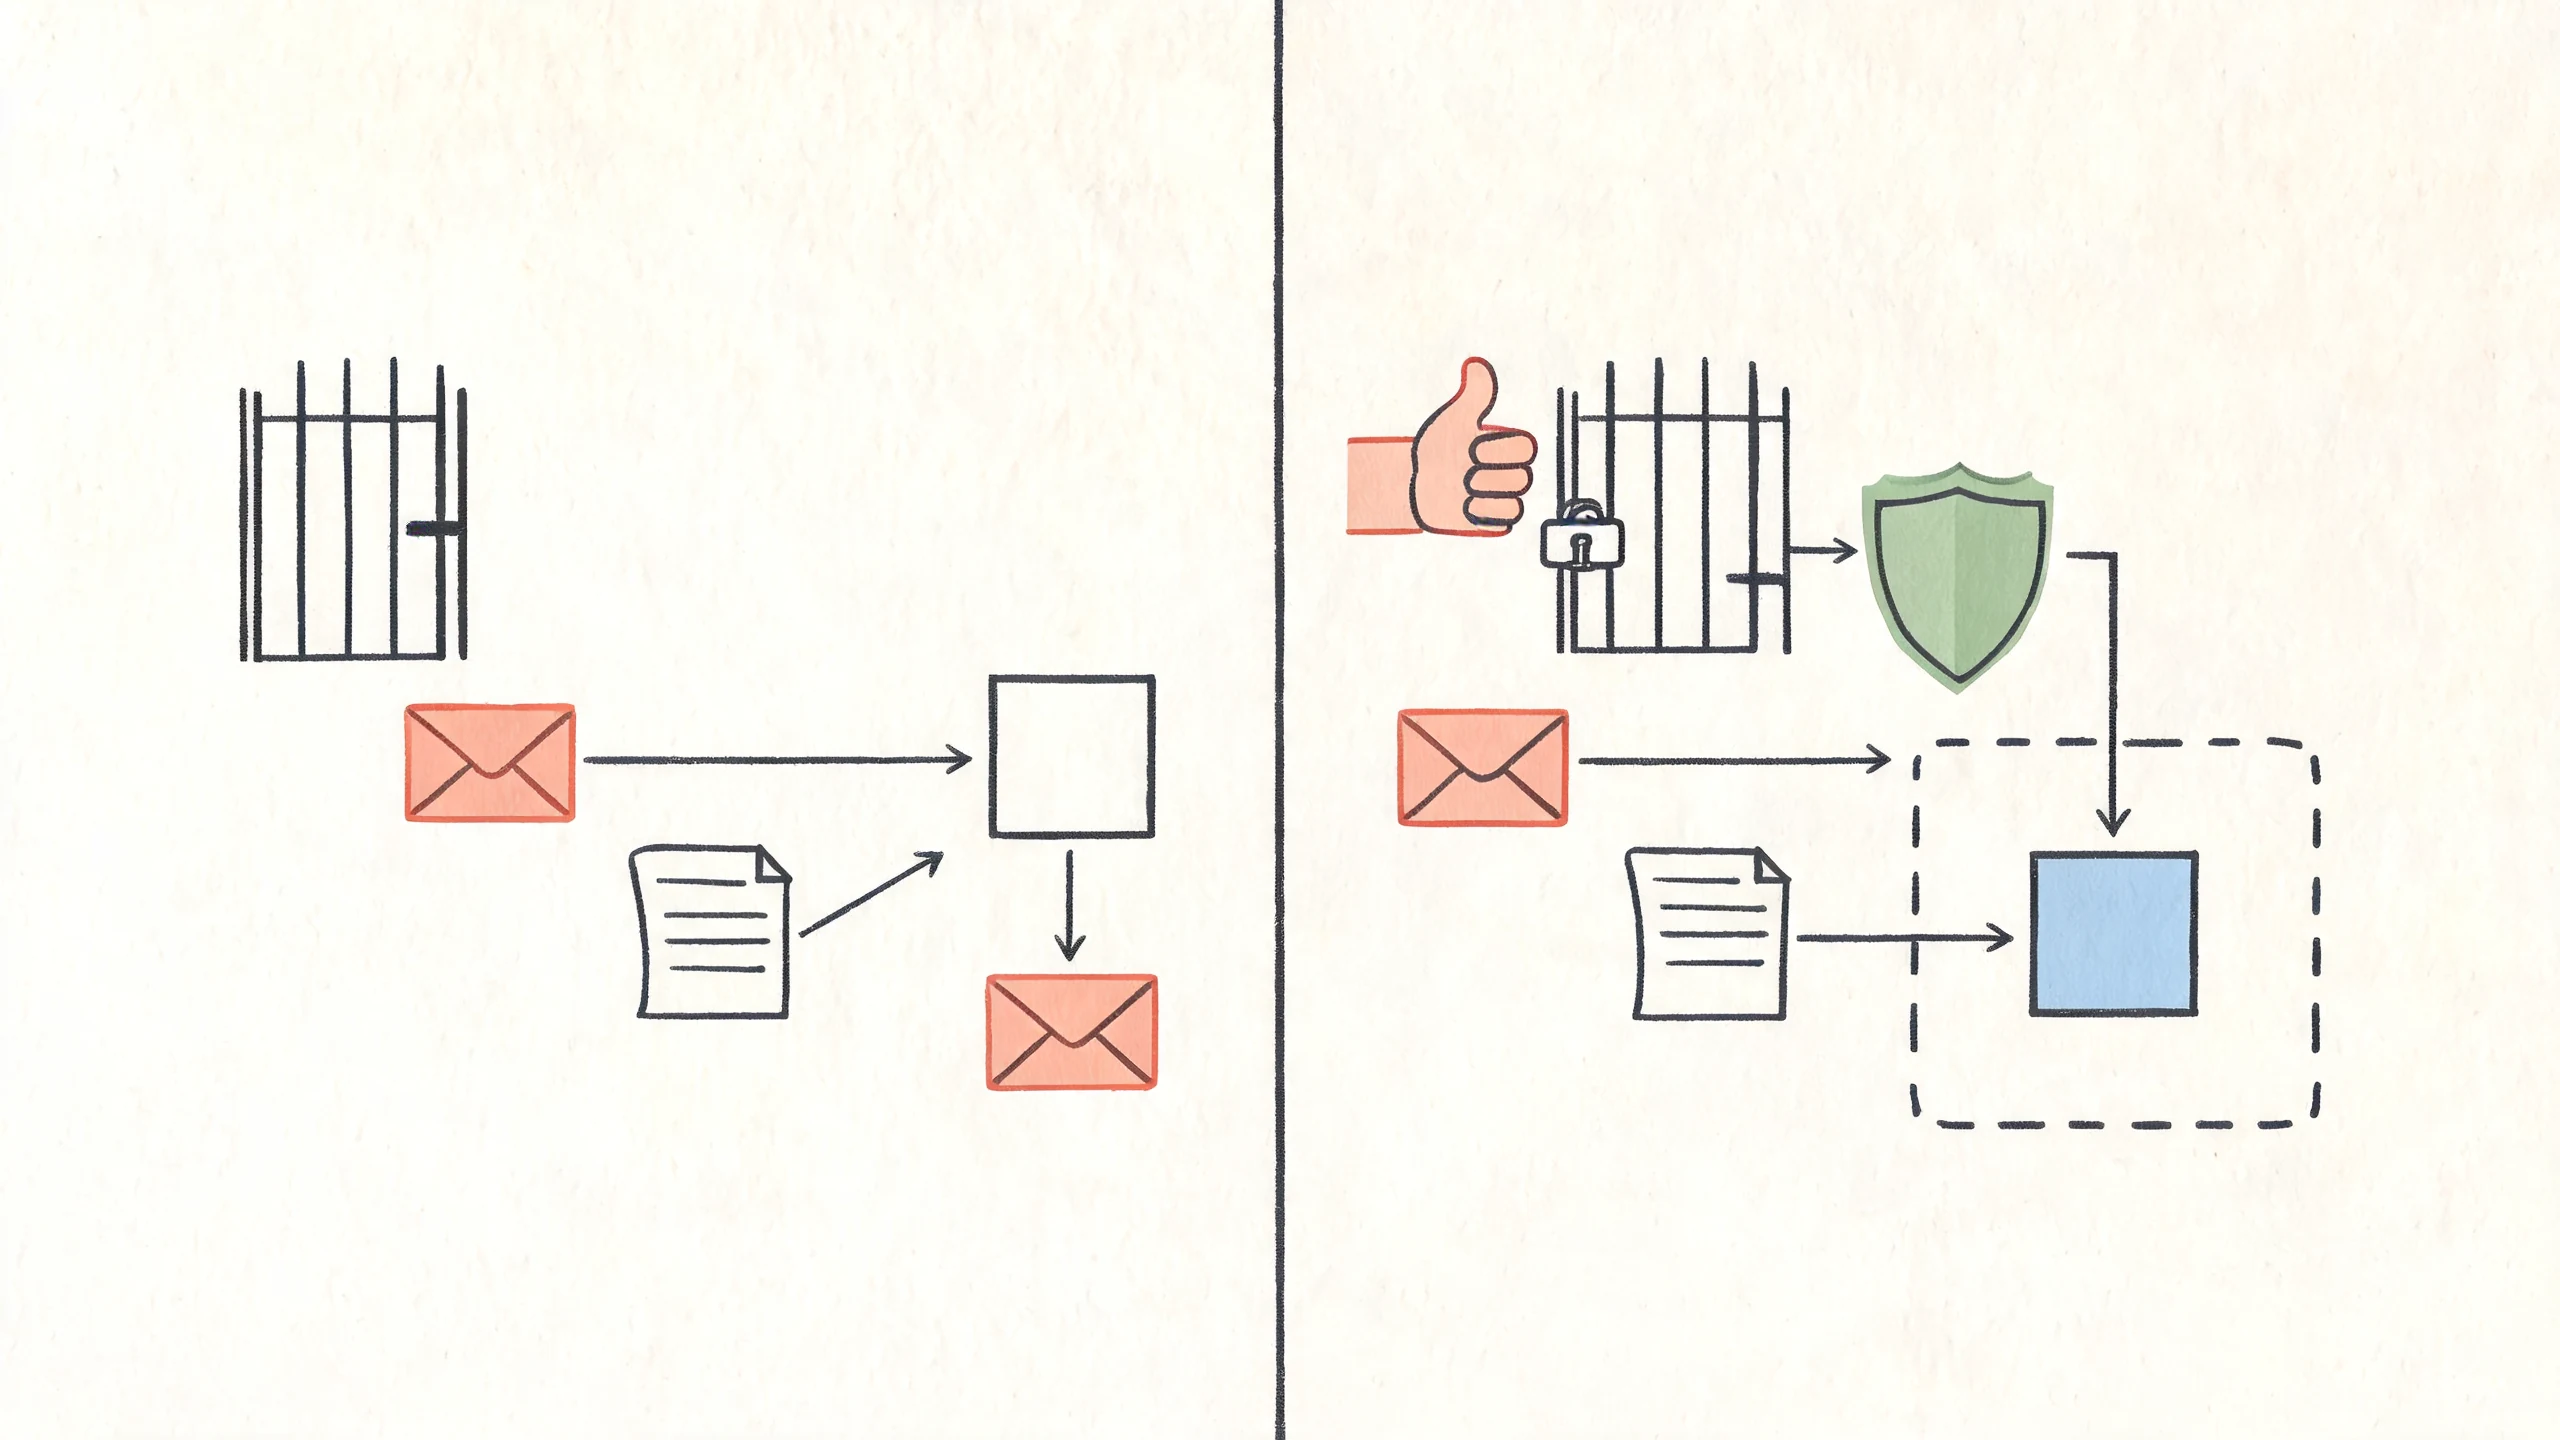
图 3:高优先级指令仍需应用授权与隔离共同约束。
模型返回的是候选数据。涉及工具或状态变更时,应用应使用自己的身份、资源与策略信息做授权;解析失败、无法确认权限或审批过期时,都应停止该动作。
- 密钥只从环境变量读取,绝不写进代码、日志、Trace。
user/tool内容默认不可信;结构化输出解析失败要安全失败(拒绝执行),不猜测补全。
九、性能与成本
- 结构化输出可减少「二次解析/重试」的往返,间接降本。
- 流式改善首字延迟;批处理与缓存见 18。
十、框架差异
- LangChain 用
with_structured_output、OpenAI SDK 用response_format/工具、其他框架各有封装。底层都是「约束输出 + 事后校验」,本章的校验函数与框架无关,可直接复用。
十一、关联章节
- 下一章:04 Prompt 工程
- 相关:06 工具调用、05 上下文工程、15 可靠性
面试复述
稳定接入模型 API 要同时管理消息角色、超时、重试、结构化输出和流式状态。模型返回的数据只能视为不可信候选值,必须经过 Schema 与业务校验后才能进入工具或状态机。
复述时先给结论,再补机制、适用边界和一个可验证指标;不要只罗列框架名称或产品功能。
迁移练习
为现有模型客户端增加四类可区分错误:网络超时、限流、非法 JSON 和业务字段越界,并为每类错误定义是否重试及回退策略。
检索关键词
Chat Completions 消息角色 system user assistant tool response_format JSON Schema 结构化输出校验 流式输出 streaming LLM 客户端封装
官方来源
- OpenAI Chat Completions / Structured Outputs 官方文档;各厂商兼容接口文档(以目标服务为准,
verified_at: 2026-09-07)。